Agustin Sansone
 Privat
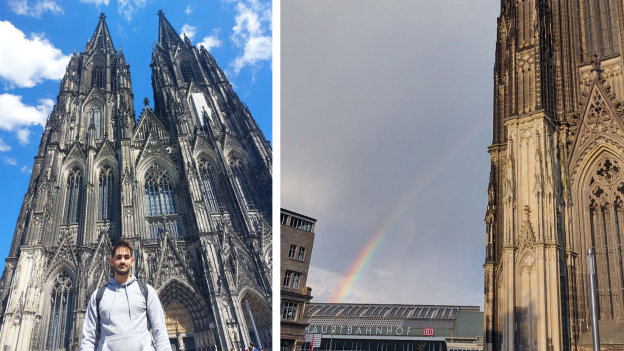
Blauer Himmel und Regenbogen am Kölner Dom
„Die Unterstützung der DAAD-Stiftung hat mir ermöglicht, in Deutschland zu forschen, meine wissenschaftliche Qualifikation zu verbessern und Lebenserfahrung in einer neuen Kultur zu sammeln. Es war sowohl beruflich als auch persönlich eine unglaublich bereichernde Reise.“
Im Rahmen seiner Promotion forschte Agustín Sansone an der Rekonstruktion des menschlichen Gehirns mittels tiefer neuronaler Netzwerke. Mit Unterstützung des UNICORE Stipendiums der DAAD-Stiftung konnte er sein Projekt am Forschungs-zentrum Jülich vor allem aufgrund dessen umfangreicher Datenbestände und fortschrittlicher Rechenkapazitäten voranbringen. Er empfand Deutschland als sehr gastfreundlich und könnte sich vorstellen, in Zukunft hier zu leben.
Wesentliches Ziel meines Forschungsprojekts war die Entwicklung tiefer neuronaler Netze, um 3D-Punktwolken-Gehirnkonfigurationen auf Basis von Laplace-Beltrami-Formdeskriptoren (LBSD) zu erzeugen. Diese Deskriptoren, die aus der Differential-geometrie abgeleitet sind, beinhalten geometrische und topologische Eigenschaften, die 3D-Objekten zu eigen sind. Die systematische Untersuchung von Veränderungen an LBO-Merkmalen könnte Einblicke in die Geometrie des Gehirns und deren Zusammenhang mit individuellen Merkmalen liefern. Als Haupthypothese gehen wir davon aus, dass die von Marin et al. 2021 vorgestellten Konzepte auf unseren Kontext anwendbar sind: das menschliche Gehirn.
Während meiner Ausbildung in Argentinien besuchte ich deutsche Schulen, daher musste ich die Sprache in höherem Alter nicht erst von Grund auf lernen. Als ich in Deutschland ankam, hatte ich das Gefühl, die meisten Deutschkenntnisse vergessen zu haben, aber nach ein paar Wochen kam alles wie von selbst wieder. Ich glaube, dass ich mit gezieltem Lernen und Übungen innerhalb weniger Monate mein bisheriges C1-Niveau noch verbessern kann.
Privat
Ankunft am Flughafen Frankfurt
In Bezug auf die Infrastruktur ist das Forschungszentrum Jülich ein ziemlich standardmäßiger Arbeitsplatz: Jeder hat ein Büro mit Whiteboards, Konferenzräumen und allem, was man zum Arbeiten benötigt. In unserem Bereich ist alles, was wir wirklich brauchen, ein Computer, daher ist kein Hightech-Labor voller Geräte notwendig. Natürlich stand uns eine Menge Hardware zur Verfügung, die wir zum Training unserer ML-Modelle nutzen konnten. Ganz besonders hat mir gefallen, dass der Campus in Jülich aus vielen Gebäuden mit unterschiedlichen wissenschaftlichen Disziplinen besteht.
In Bezug auf das Projekt gelang es uns, Konzepte aus vorhergehenden Arbeiten an unseren speziellen Kontext des menschlichen Gehirns anzupassen und anzuwenden. Zudem hatte ich die Möglichkeit mit großen Rechnerclustern zu arbeiten: Das ist etwas, das mir in meinem Labor in Buenos Aires einfach nicht möglich ist. Unserer Universität fehlen Ressourcen, wie z. B. GPUs, und Doktoranden erhalten in der Regel nur billige Computer. Ich habe wertvolle Erfahrungen beim Training großer Modelle bei paralleler Anwendung mehrerer GPUs gesammelt.
Privat
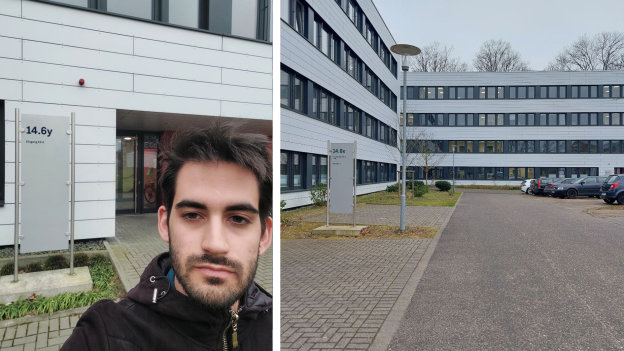
Vor dem Forschungszentrum Jülich
Mein zukünftiger Weg und der Einfluss des Forschungszentrums Jülich: Ich kann sagen, dass dieser Forschungsaufenthalt meine wissenschaftliche Laufbahn wirklich beeinflusst hat. Ich verfüge jetzt über mehr praktische Tools und Erfahrungen.
Zudem hatte ich die Möglichkeit zu beobachten, wie die Forschung in einem anderen Labor in einer ganz anderen Region der Welt durchgeführt wird. Dies hat meine Sichtweise verändert, wie Wissenschaft in anderen Labors gehandhabt wird. Die Forschungsgruppe in Jülich war eine freundliche Gruppe aus internationalen Mitgliedern.
Privat
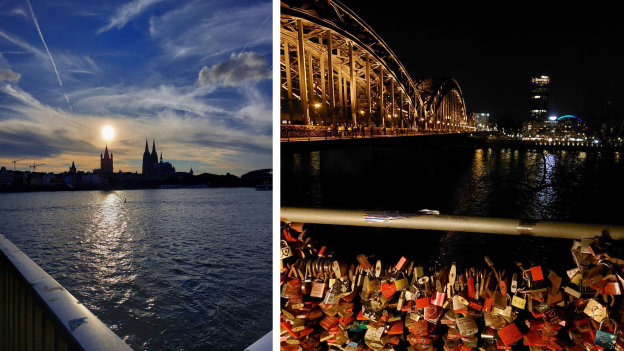
Besuch in Köln mit Blick auf den Rhein
Was mein Privatleben anbelangt, fühlten sich die meisten Städte in Deutschland ruhiger und friedlicher an als Buenos Aires, wo ich herkomme. Ich konnte beobachten, wie die Menschen zu jeder Uhrzeit Parks, Spaziergänge am Fluss, Bars und Veranstaltungen genießen.
Im Gegensatz zu Argentinien, wo es gefährlich ist, nachts allein unterwegs zu sein, fühlte ich mich auch extrem sicher. Mir hat auch die WG-Kultur gefallen. Sie hat mir ermöglicht, täglich Kontakt zu Deutschen zu haben und viel zu lernen.
Privat
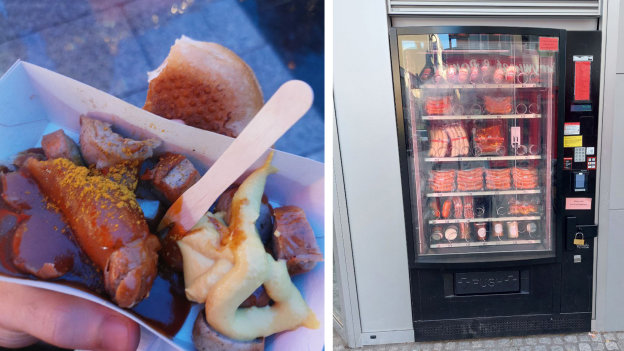
Wurst ist nie weit entfernt: Currywurst und Wurstautomat
Nach dieser Erfahrung könnte ich mir gut vorstellen, langfristig in Deutschland zu leben. Die Gehälter sind höher, die Kultur ist reichhaltig und ich fand die Einheimischen freundlich und offen. Es ist zudem viel sicherer und stabiler, um eine Familie zu gründen. Auch das Bildungssystem hat mich beeindruckt: Die meisten Deutschen, die ich getroffen habe, sprechen mindestens drei Sprachen, sind neugierig und gut ausgebildet.
Privat
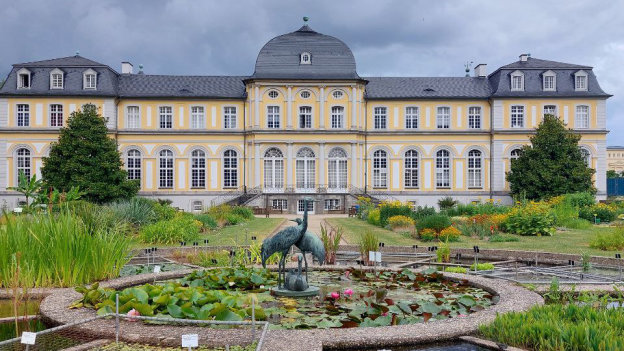
Ein Ausflug nach Bonn: Das Poppelsdorfer Schloss
Ich hoffe, dass Kollegen aus meinem Labor in Argentinien bei künftigen Kooperationen zu einem Austausch nach Jülich kommen können. Die Ressourcen sind sehr wertvoll und in unserem heimischen Labor nicht verfügbar. Da wir alle an ähnlichen Themen arbeiten, wäre es für jeden von Vorteil.
Stand: Juli 2025. Die englische Version ist das Original.
Detaillierte Informationen über die technischen Aspekte von Agustin Sansones Forschung finden Sie hier:
Daten
Wir haben Daten der UK Biobank verwendet, die MRT-Aufnahmen und persönliche Merkmale von etwa 50.000 Personen beinhaltet. Nach einigen Filtervorgängen haben wir 20.998 gesunde Personen zum Training und 5.256 für Tests berücksichtigt.
Zur Segmentierung der Gehirnstrukturen (z. B. Hippocampus, Amygdala, Nucleus caudatus usw.) wurde FreeSurfer verwendet. Anschließend wurden 3D-Punktwolken mit BrainPrint erzeugt, ein Netz angepasst und die Laplace-Beltrami-Operator (LBO)-Zerlegung angewendet, um die LBSDs zu erhalten.
Sobald wir die berechneten Netze für jede Gehirnregion ermittelt haben, wandeln wir diese in ein Bild mit 86x86x86 Pixeln um. Das vorverarbeitete Bild beinhaltet eine 1 oder 0 in jedem Pixel. Dies symbolisiert, ob dieser Punkt sich innerhalb oder außerhalb der Gehirnregion befindet, die durch das Netz dargestellt wird. Da jedes Pixel der Granularität entspricht, die durch den tatsächlichen MRT-Rohscan gemessen wird, findet bei dieser Umwandlung kein Informationsverlust statt.
Modellarchitektur
Zentraler Ansatz dabei ist eine AutoEncoder (AE)-Architektur, bei der eine 3D-Punktewolke (X) und ihr entsprechendes Laplace-Spektrum (Spec(X)) in das Netzwerk eingegeben werden. Mithilfe des AE soll eine Rekonstruktion erzwungen werden, so dass X in etwa gleich X̃ ist. Dabei steht X für die Gehirnstruktur und Spec(X) bezeichnet ihr Spektrum.
Die Architektur besteht aus vier Hauptblöcken: Encoder (E), Decoder (D), Spektralencoder (π) und Translation (ρ), die alle durch das neuronale Netzwerk erlernbar und parametrisiert sind. Ziel des Modells ist es, die Wiederherstellung der Gehirnaktivität ausschließlich anhand ihrer Eigenwerte über die Zusammensetzung D(π(Spec(X))) ≈ X zu ermöglichen.
Wir haben für jeden Hauptblock unterschiedliche Architekturen untersucht. Am besten funktioniert hat die Integration von konvolutionalen neuralen Netzen (CNN) in die Architektur, was natürlich den Verlust von räumlichen Informationen berücksichtigt, der bei der Verwendung vollständig verbundener Netze in 3D-Strukturen auftritt.
Residuelle Verbindungen waren ebenfalls hilfreich, da sie das Vanishing-Gradient-Problem lösen und das Training tieferer Netzwerke ermöglichen. Das Hinzufügen von Dropout-Schichten war entscheidend, um ein Overfitting des Problems zu vermeiden. Batch-Normalisierungsschichten reagierten ebenfalls sehr empfindlich auf diesen Datensatz. Fehlten einige dieser Schichten, kam es vor, dass das Modell leicht in lokalen Minima stecken blieb.
Es wurden verschiedene Feature-Engineering-Versuche unternommen, indem Berechnungen mit konsekutiven Eigenwerten durchgeführt wurden; diese Idee führte allerdings in keinem Fall zu einer Verbesserung der Prognosen. Es wurde mit Vorwärtsausbreitung getestet, um eine endgültige Prognose für das Bild aus dem Spektrum ohne Blöcke wie den Encoder oder den ρ-Block zu erstellen. Empirisch betrachtet war es aber in keinem Fall besser, diese Blöcke aus der Architektur zu entfernen.
Endgültige Hyperparameter
Um die Konsistenz mit früheren Arbeiten zu erhalten, haben wir das Training mit den ersten 50 Eigenwerten berücksichtigt, obwohl die ersten 100 Eigenwerte berechnet wurden. In unserer endgültigen Konfiguration haben wir die Modelle für 20 Epochen trainiert, wobei wir mit einer Lernrate von 0,1 begonnen haben, die nach der 10. Iteration auf 0,01 reduziert wurde. Die Batchgröße liegt bei 512 (eine größere war aufgrund der Hardware-Einschränkungen nicht möglich). Optimierer ist Adam und das Kriterium MSE.
In jeder Schicht des Netzes wird die ReLu-Aktivierungsfunktion eingesetzt, mit Ausnahme der letzten Schicht im Decoder, wo Sigmoid verwendet wird. Der Dropout-Faktor jeder konvolutionalen Schicht beträgt 0,1 und die Dynamik in jeder Batch-Normalisierungsschicht liegt bei 0,01. Die Box als Eingabe und Ausgabe hat eine Größe von 86, während die Latent-Space-Box nur eine Größe von 5 hat. Die Anzahl an internen Schichten in den Blöcken π, ρ, Encoder und Decoder beträgt 6.
Bei der aktuellen endgültigen Konfiguration dauert es 2 bis 3 Tage, um ein Modell mit 4 parallelen GPUs zu trainieren. Das endgültige Modell verfügt über 640.852 trainierbare Parameter. Die Aufteilung zwischen Training und Test wurde auf 80 % und 20 % festgelegt.
Verlustfunktion
Die Verlustfunktion wird von Marin et al. wie folgt definiert: |E(X)-π(Spec(X))| + c * |D(E(X))-X| + c * |ρ(E(X))-Spec(X)| Wobei c ein kleiner konstanter Wert ist. Alternativ dazu haben wir die nachstehende Verlustfunktionsgruppe vorgeschlagen: |D(π(Spec(X)))-X| + c * |E(X)-π(Spec(X))| + c * |ρ(π(Spec(X)))-Spec(X)|
Beachten Sie, dass der Begriff des latenten Raums nun nicht mehr am wichtigsten ist. Zudem haben wir |D(E(X))-X| durch |D(π(Spec(X)))-X| ersetzt, was letztendlich auch der Art und Weise entspricht, wie die Prognose tatsächlich berechnet wird. Ebenso haben wir ‘ρ(E(X))’ durch ‘ρ(π(Spec(X)))’ ersetzt; dies scheint jedoch keinen großen Einfluss auf die Ergebnisse gehabt zu haben.
Wie zu erwarten war, ist der Prognosefehler bei dieser Alternative geringer, der gelernte latente Raumfehler jedoch größer.
Wir haben festgestellt, dass einige Regionen viel größer waren als andere. Dieses Problem ähnelt konzeptionell dem Klassenungleichgewicht bei Klassifizierungsaufgaben. Um dieses zu reduzieren, haben wir eine gewichtete Verlustfunktion eingeführt.
Offene Ideen
Eine Idee besteht darin, bei einem vollständig trainierten Modell bestimmte Eigenwerte der Eingabe manuell zu ändern, um zu untersuchen, wie sich dies auf die Prognose auswirkt. Es gibt frühere Arbeiten, die die Breite, Höhe und Tiefe der Strukturen mit den ersten drei Eigenwerten in Beziehung setzen. Es wäre daher interessant zu sehen, wie man mit diesen Beziehungen experimentieren könnte, indem man mit künstlich veränderten Eigenwerten spielt.
Die andere besprochene Idee hat mit dem als „Proof of Concept“ bekannten Begriff zu tun. Dies ist ein allgemeiner Ansatz in diesem Bereich, der dazu beiträgt, etwas komplexeren Modellen ein gewisses Maß an Interpretierbarkeit zu verleihen. Dabei wird das trainierte neuronale Netzwerk untersucht, um zu beurteilen, ob es einige für Menschen verständliche „Konzepte” gelernt hat oder nicht.
Dies geschieht, indem lineare Klassifikatoren an die Aktivierungsfunktionen verschiedener Schichten angepasst werden, um festzustellen, ob dadurch ein bestimmtes Konzept (z. B. „die Gehirnregion ist symmetrisch“, „sie hat ein Loch im Inneren“, „sie befindet sich eher im Inneren oder in der Nähe des Kortex“, „sie befindet sich eher in der linken oder rechten Gehirnhälfte“, „sie befindet sich in der Nähe einer bestimmten Region“) prognostiziert werden kann. Kann das Konzept linear aus der Aktivierungsfunktion einer Schicht entschlüsselt werden, deutet dies darauf hin, dass das Netzwerk dieses Konzept in dieser Phase intern dargestellt hat.
Zukunft
Geplant ist, diese Teilergebnisse weiter zu verfeinern, die noch offenen Ideen umzusetzen und die Arbeit anschließend bei einer relevanten Fachzeitschrift einzureichen.